TL;DR: 영상 메타포 이해를 위한 벤치마크(MetaphorVU-Bench)을 제안하고 MLLM모델을 평가한 뒤 bottleneck을 파악하여 그래프 지식 구조를 활용한 MetaphorBoost를 제안함.
PAPER REVIEW
MetaphorVU: Towards Metaphorical Video Understanding
§1Before reading
- 은유란 주관적인 해석을 포함할 수 밖에 없는데 이걸 어떻게 평가하는가?
- 영상의 길이는 얼마나 긴가?
- 플롯을 이해하고 은유해석에 적용할 수 있는가?
§2Background
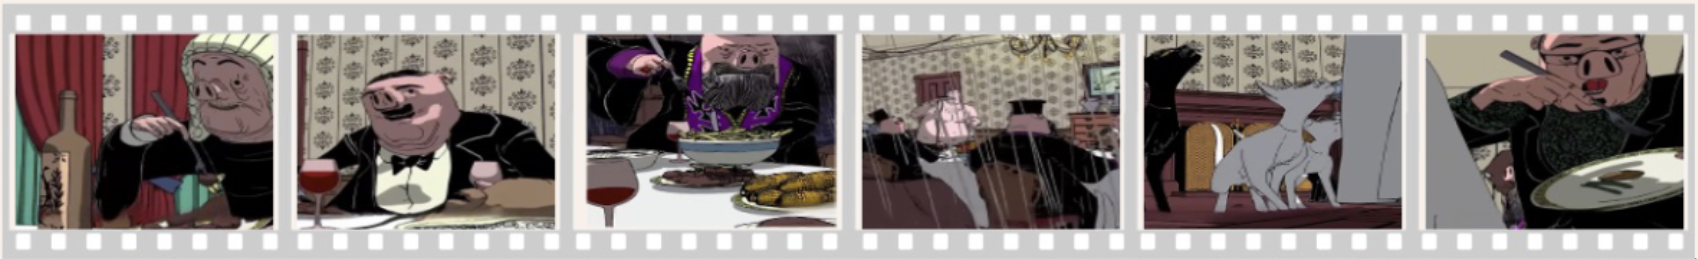 은유적 의미를 담고있는 컨텐츠들은 소셜 미디어 및 다양한 플랫폼의 형태로 쉽게 접할 수 있다. 제작자의 입장에서 누군가의 감시를 피하기 위한 수단으로 혹은 예술적 가치를 추구하기 위해 영상에 의도적으로 메타포를 포함 시킨다. 해당 애니메이션 예시는 돼지 -> 부유층, banquet -> wealth, 고양이 -> 서민층 등으로 피상적 표현과 내포하는 의미를 매핑을 시킬 수 있다.
메타포 비디오 이해를 위해 벤치마크 MetaphorVU-Bench를 제안하고 다양한 MLLM모델에 평가하여 bottleneck(cross-domain mapping)을 찾음. 지식 그래프 기반으로 매핑 보강을 통해 MLLM모델들의 은유 이해에 도움을 줌. Training-free이며 지식 그래프 구축하고 사용하는 방식이라, 모든 MLLM에 적용할 수 있다.
+++ 은유를 분석하기 위해선 4가지 요소를 알아둘 필요가 있다. Tenor(원관념), Vehicle(보조관념), Ground(공통 기반), Tension(상충). "Juliet is the sun"의 예시를 함께 보자. 여기서 화자가 말하고 싶은 원관념은 Juliet일 것이다. 이에 대한 보조관념은 the sun. Juliet과 the sun의 ground는 중요함, 에너지의 근원, 누군가에겐 없어서는 안 될 존재 정도로 유추 해볼 수 있다. 마지막으로 Tension, 사람은 태양이 될 수 없다.
그렇다면 창작자는 하고싶은 말을 직접적으로 전달하지 않고 왜 굳이 숨겨놓는가? 이는 수사학과 연관되어 있다. 수사학은 인간이 언어나 매체를 사용해 타인과 소통하고 자신의 생각이나 감정을 매력적으로 전달하는 방법을 연구하는 학문이다. 앞선 예시를 "Juliet shines like the sun"처럼 직유(simile)를 사용해 전달 할 수도 있다. 직유 역시 두 대상을 연결하는 ground가 존재하지만 은유는 성립하지 않는 모순(tension)을 통해 추상적인 개념을 연결 시킬 수도 있다. 은유는 내포되는 의미를 직접적으로 표현하지 않고 독자에게 유추하게 하면서 해석의 자유를 준다. 영상 매체에서는 전달하고자 하는 설명(장면)들을 생략함으로써 전달의 경제성을 추구하기도 한다.
§3Previous Works
은유 이해에 대한 이전 연구들은 텍스트나 이미지에 초점이 맞춰져 있다. 텍스트 은유의 경우 토큰 간의 관계를 기반으로 source와 target을 식별하는 것을 목표로한다. 이미지 은유는 인터넷 밈과 같은 데이터셋을 구축하여 멀티모달 fusion을 하는 방식으로 발전되어왔다. 비디오 은유는 시간적 특성이 추가되며 더 복잡한 은유 해석을 필요로한다.
비디오 심층 이해 객체인식이나 이벤트 설명을 넘어 다양한 목적으로 심층 이해를 연구한다. 도메인 지식을 설명하고 비디오에 나와있지 않은 새로운 문제를 해결하는 해결하거나, 완성되지 않은 이벤트를 통해 숨겨진 인과관계를 추론하는 task도 있다. 영상 은유 관련해서는 광고영상에 대해 은유 데이터셋을 만들어 해결하는 previous work이 있지만, 도메인이 한정적이며 비디오 은유 이해 자체는 초기 단계에 머물러있다고 볼 수 있다. 최근에는 비디오의 암묵적인 추론을 평가하기 위한 MMR-V가 제안 되었음. MMR-V는 광범위한 추론 능력을 평가하는 것을 목표로하며 은유 이해는 그 일부이다.
§4Approach
MetaphorVU-Bench. 비디오 은유 이해를 측정하기 위한 벤치마크가 마땅치 않기 때문에 데이터셋을 만들어 공개하였다. 제안한 MetaphorVU-Bench는 mise-en-scene, symbolism, montage, theatre 이론에 근거하여 4가지 중분류로 나뉘며 이 또한 8개의 세부카테고리로 분류할 수 있다. Body, atmosphere, cultural, naturalistic, causal, analogical, surreal, performative로 나뉜다는데 개인적으론 일부 동의할 수 없는 예시나 분류도 있지만, 그렇다고한다. 데이터셋은 중국 숏츠 플랫폼에서 영상을 따와 댓글 필터을 거쳐 영상 설명 및 댓글을 긁어 chatgpt에 넣어주어 은유가 포함되었는지 추가 필터링한다. 댓글에 포함된 질문과 답글을 통한 사람들의 소통 과정에서 은유가 포함되었는지 어느정도 필터링 할 수 있다. 다음 단계는 Gemini에게 영상과 전단계의 GPT reasoning 출력값을 같이 넣어주어 영상과 내용이 일치하는지 확인한다. 마지막으로 사람이 개입하여 만장일치로 은유가 포함된 영상이라고 동의된 영상을 최종 선택한다. 선택된 영상에 대해 최종 annotator가 은유 해석을 작성하고 이 또한 만장일치가 나올때까지 수정한다. 이 과정을 통해 은유 해석이 포함된 30초 내외의 860개 영상을 얻을 수 있다.
MLLMs on MetaphorVU-Bench 제안한 벤치마크에 MLLM모델들을 평가한다. 수식적으로는 로 v는 영상, t는 제목 으로 출력값은 각각 사고 과정, 은유해석이다. 은유해석에 대한 평가로는 LLM-as-judge로 DeepseekV3.2를 사용했다. 폐쇄형 모델로는 흔히 쓰는 GPT5, GPT4o, Qwen3VL, Gemini 시리즈, 오픈 모델로는 Qwen시리즈, LLaVA-onevision을 포함한다. reasoning 모델도 포함되었는데, RL기반의 사후 학습 방식이라고한다.
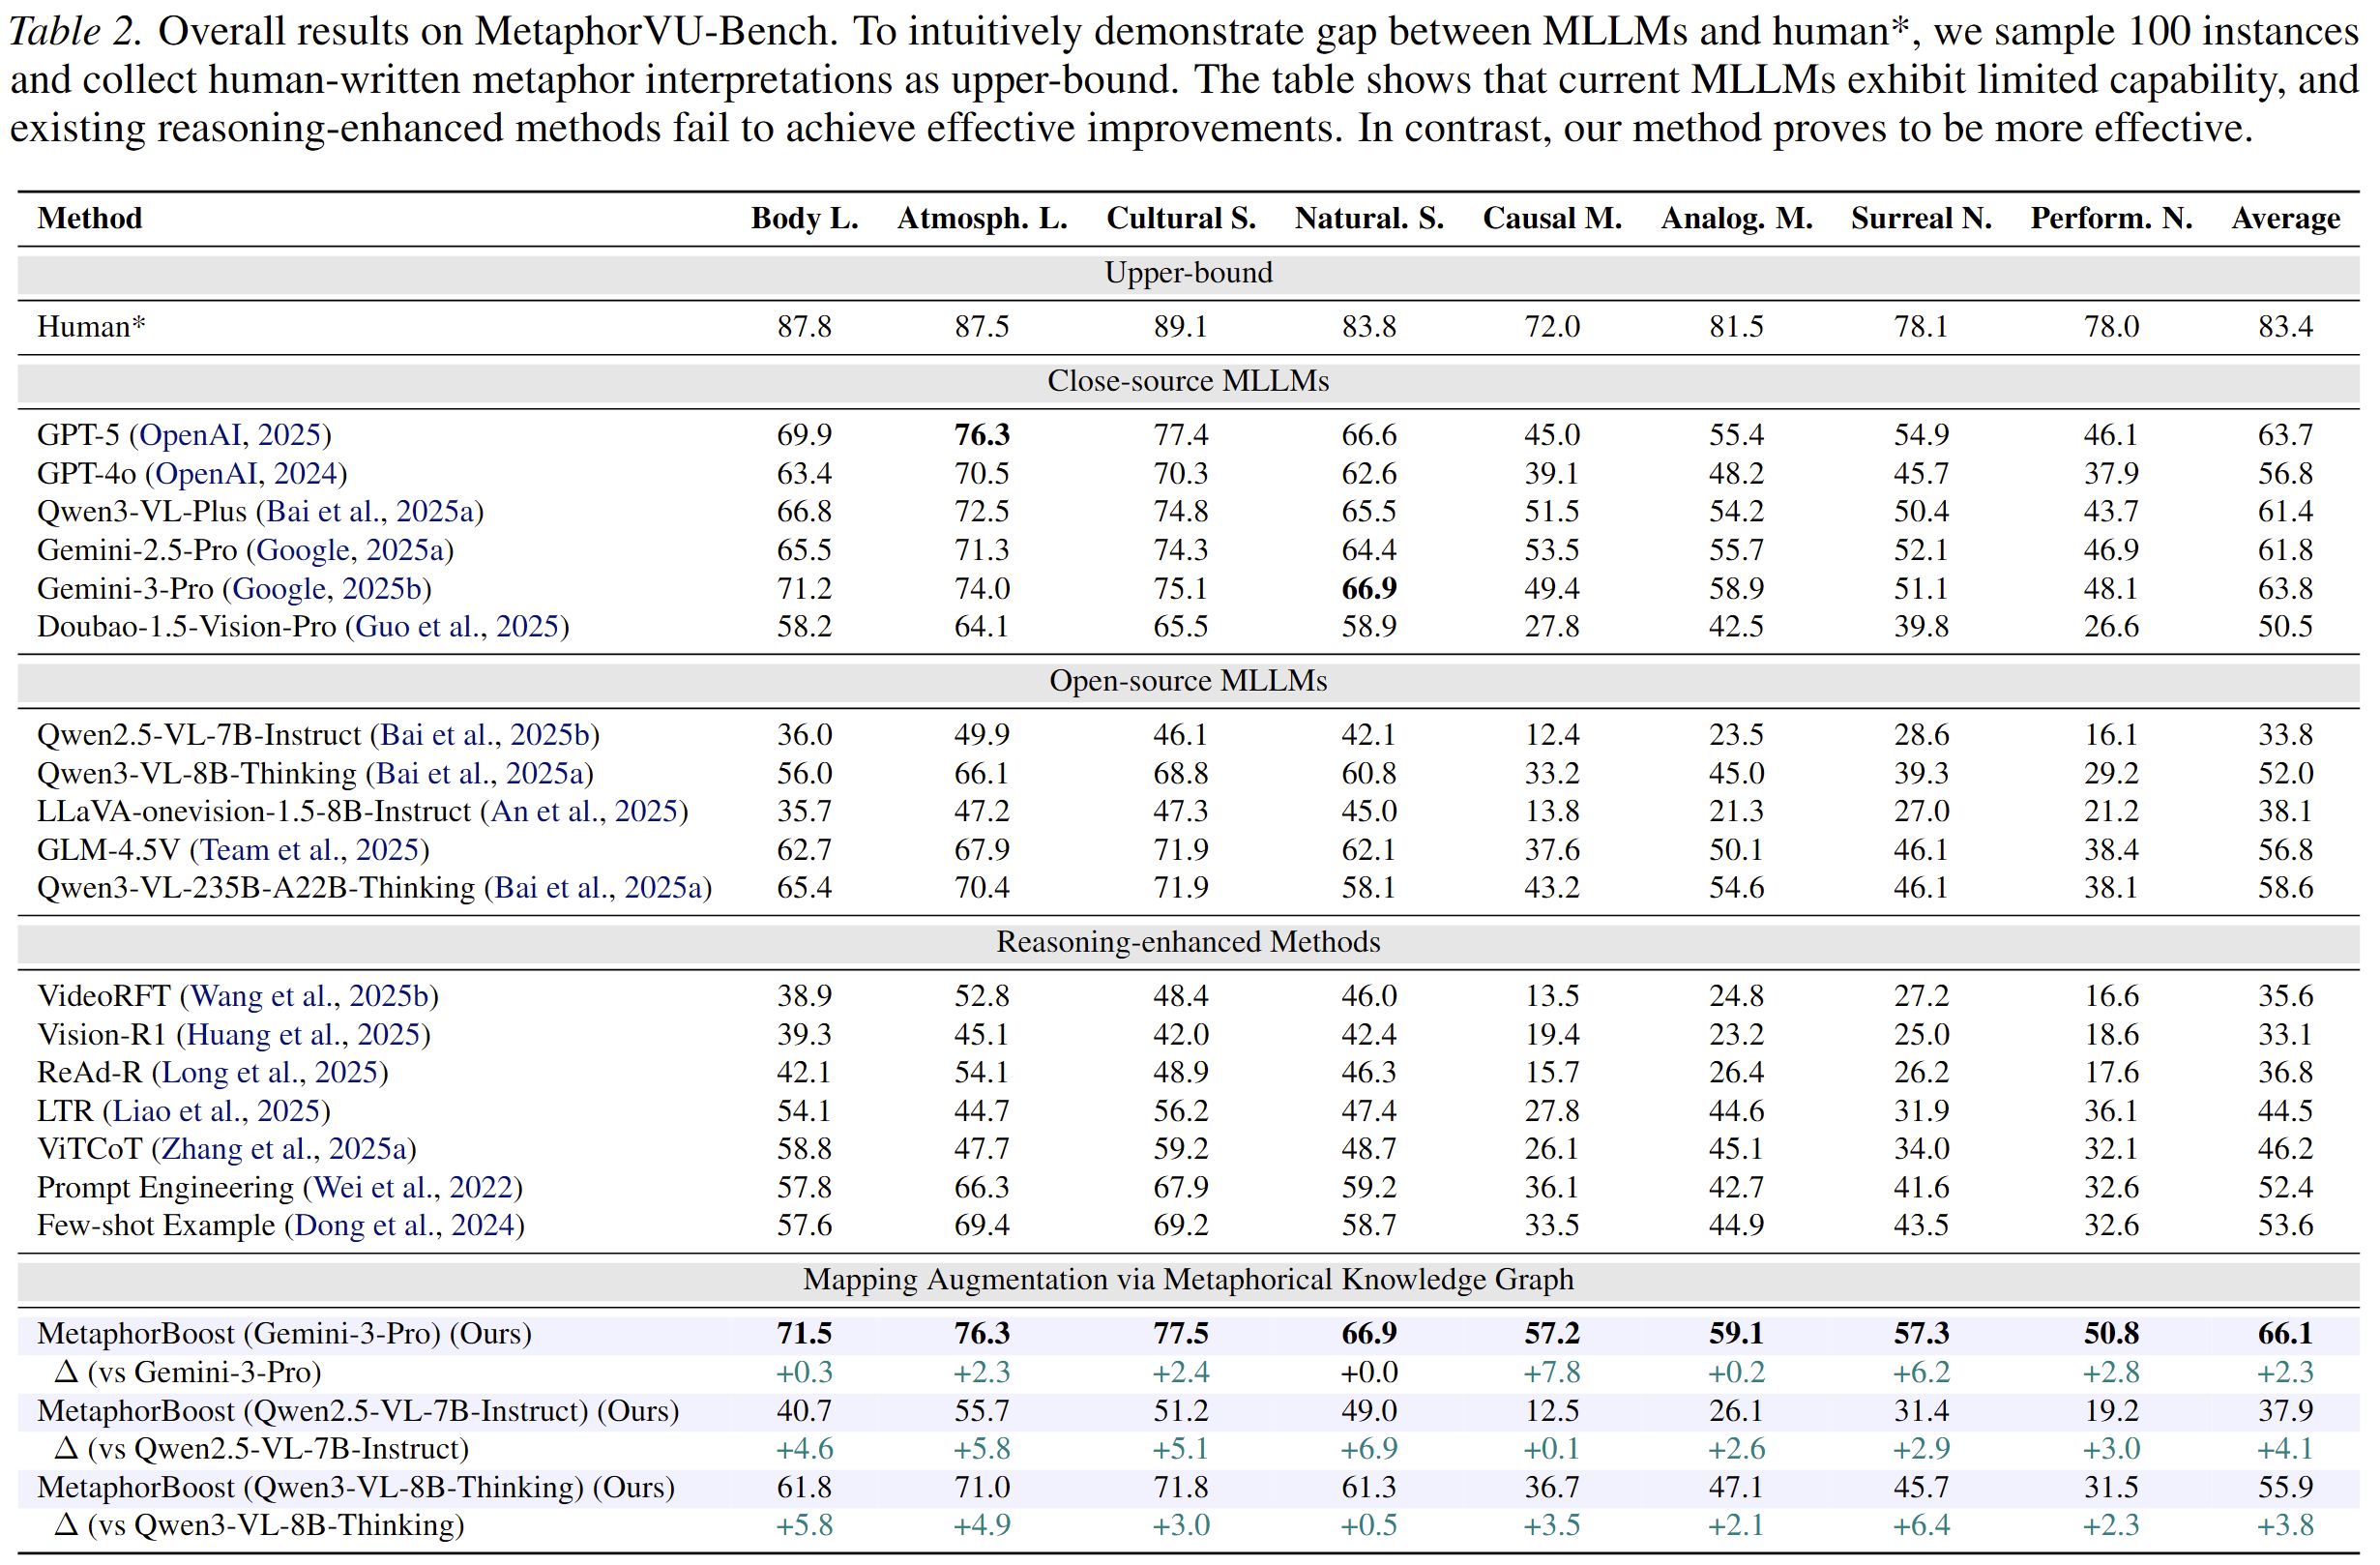 리포트한 성능인데 Gemini-3-Pro가 63.8로 가장 높고 오픈모델에서는 역시 Qwen3-VL-8B-Thinking이 52점. 여전히 룸이 존재한다. 간단한 분석을 하였는데, Wrong recognition, missing mapping, superficial mapping, improper mapping으로 분류하여 어디에서 가장 많이 놓치는지 비율을 나눠놨다.
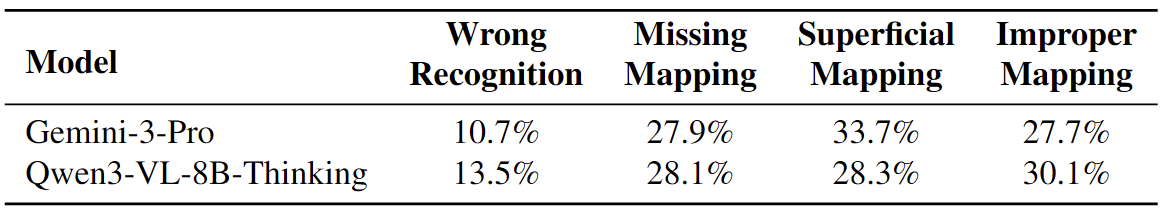 위 테이블에서 알수있듯, 인식에서는 큰 문제가 없고, 매핑이 아예 안되거나 피상적인 의미를 파악한경우, 아예 틀린 경우로 나눈다. "We manually observe and identify 4 common types of deficiency in MLLMs thinking process". 사람이 했다. Cross-domain mapping이 대부분의 문제라는 점을 파악하고, external knowledge를 빌려오는 MetaphorBoost를 제안한다.
MetaphorBoost Cross-domain mapping을 해결하기 위해, 지식그래프를 만들었는데, 기존 텍스트 은유 데이터셋을 활용하였다. 총 54,687개의 노드와 200,268개의 엣지를 포함한다. DeepSeekV3.2를 통해 은유 개념쌍을 추출했는데, 이 과정 자체가 데이터셋에 매핑되는 pair가 있기도하지만, LLM이 은유적 표현을 이해한다는 가정이 있다.
이렇게 은유쌍을 얻고난 후는 간단하다. 기존 recognition처럼 identification으로 영상에 있는 키워드들을 얻고, 구축해놓은 KG에 query를 날려 최대 h홉으로 가장 많은 키워드와 동시에 연결되는 상위 z개의 타겟 노드를 취한다. 그리곤 MLLM 평가 방식과 같이 v, t와 함께 R개의 노드를 넣어준다. Gemini-3-Pro, Qwen2.5-VL, Qwen3-VL-Thinking에 대해 metaphorboost를 추가하여 평가했는데 평균적으로 3-4 안팎의 성능 향상을 보였으며, Gemini로 최고성능 66.1를 달성했다.
§5Experiments
MLLM 성능은 위에서 다 보여주였기 때문에, experiment 섹션은 대부분 ablation과 분석으로 되어있다.
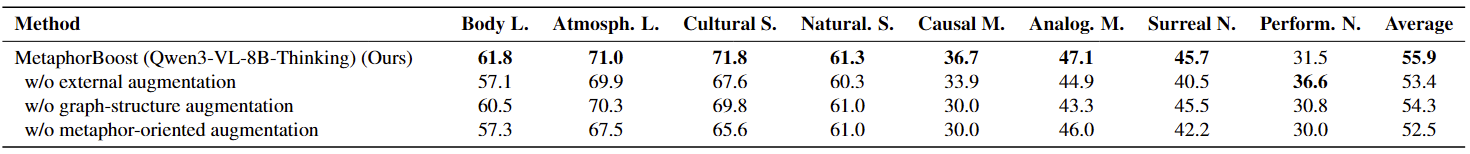 메타포 외에 CoT로 스스로 얻은 지식 혹은 ConceptNet 등의 외부 지식을 가져왔지만 당연하게도 Metaphoboost가 가장 성능이 잘 나온다. 매핑의 경우도 모델에 따라 의존성이 있지만, superficial/improper mapping에 대한 오류가 크게 줄었다.
§6After reading
- 보편적 합의를 공유하는 메타포에 대해 이야기한다. 애초에 심도있는 은유해석으로 위한 벤치마크를 만드는거 자체가 성립하지 않을 것 같음.
- 30초 내외
- causal 분류가 있었지만 플롯 이해랑은 다른 얘기
§7Takeaways
- 이젠 상용 모델로 어노테이션을 하고 벤치마크를 만드는것이 흔히 받아들여지기 때문에, 새로운 태스크을 제안하는 연구도 시도해볼만하다.
- 멀티모달 입력을 텍스트 토큰으로 일괄 치환하는 연구가 많은데, 텍스트로 담아내기 어려운 영상 고유의 페이소스까지 포착할 수 있는 연구.